个人简介

我是北京航空航天大学的博士研究生,师从李帅教授,同时在快手可灵团队担任研究实习生。我的研究围绕人脸行为的理解与生成展开,目前聚焦于对话式数字人。此外,我也担任 ICLR、CVPR、ECCV 和 ECAI 的审稿人。

近期动态

  • [2026/09/27]: 我在可灵 AI 实习满 1000 天。

  • [2026/06/18]: 一篇一作论文被 ECCV 2026 接收。

学术论文

MindFlow: Harmonizing Cognitive Semantics and Acoustic Dynamics for Facial Animation Generation in Dyadic Conversations

H. Chen, H. Zhang, X. He, et al.

我们针对双人对话面部动画中表情僵硬、情感空洞的问题, 实现了从流式语音中进行连续的情感推理, 并在说话与倾听两种状态之间生成自然衔接的面部运动。

Teaser
ECCV'26
Cafe-Talk: Generating 3D Talking Face Animation with Multimodal Coarse- and Fine-grained Control

H. Chen, H. Zhang, S. Zhang, et al.

我们聚焦于生成表情可控的三维说话人脸动画这一难题。 我们提出 Cafe-Talk,融合粗粒度与细粒度的多模态控制条件,实现条件解耦、唇形同步、表情增强与精准控制。

Teaser
ICLR'25
其他论文(2 篇)

X. He, H. Zhang, H. Chen, et al.

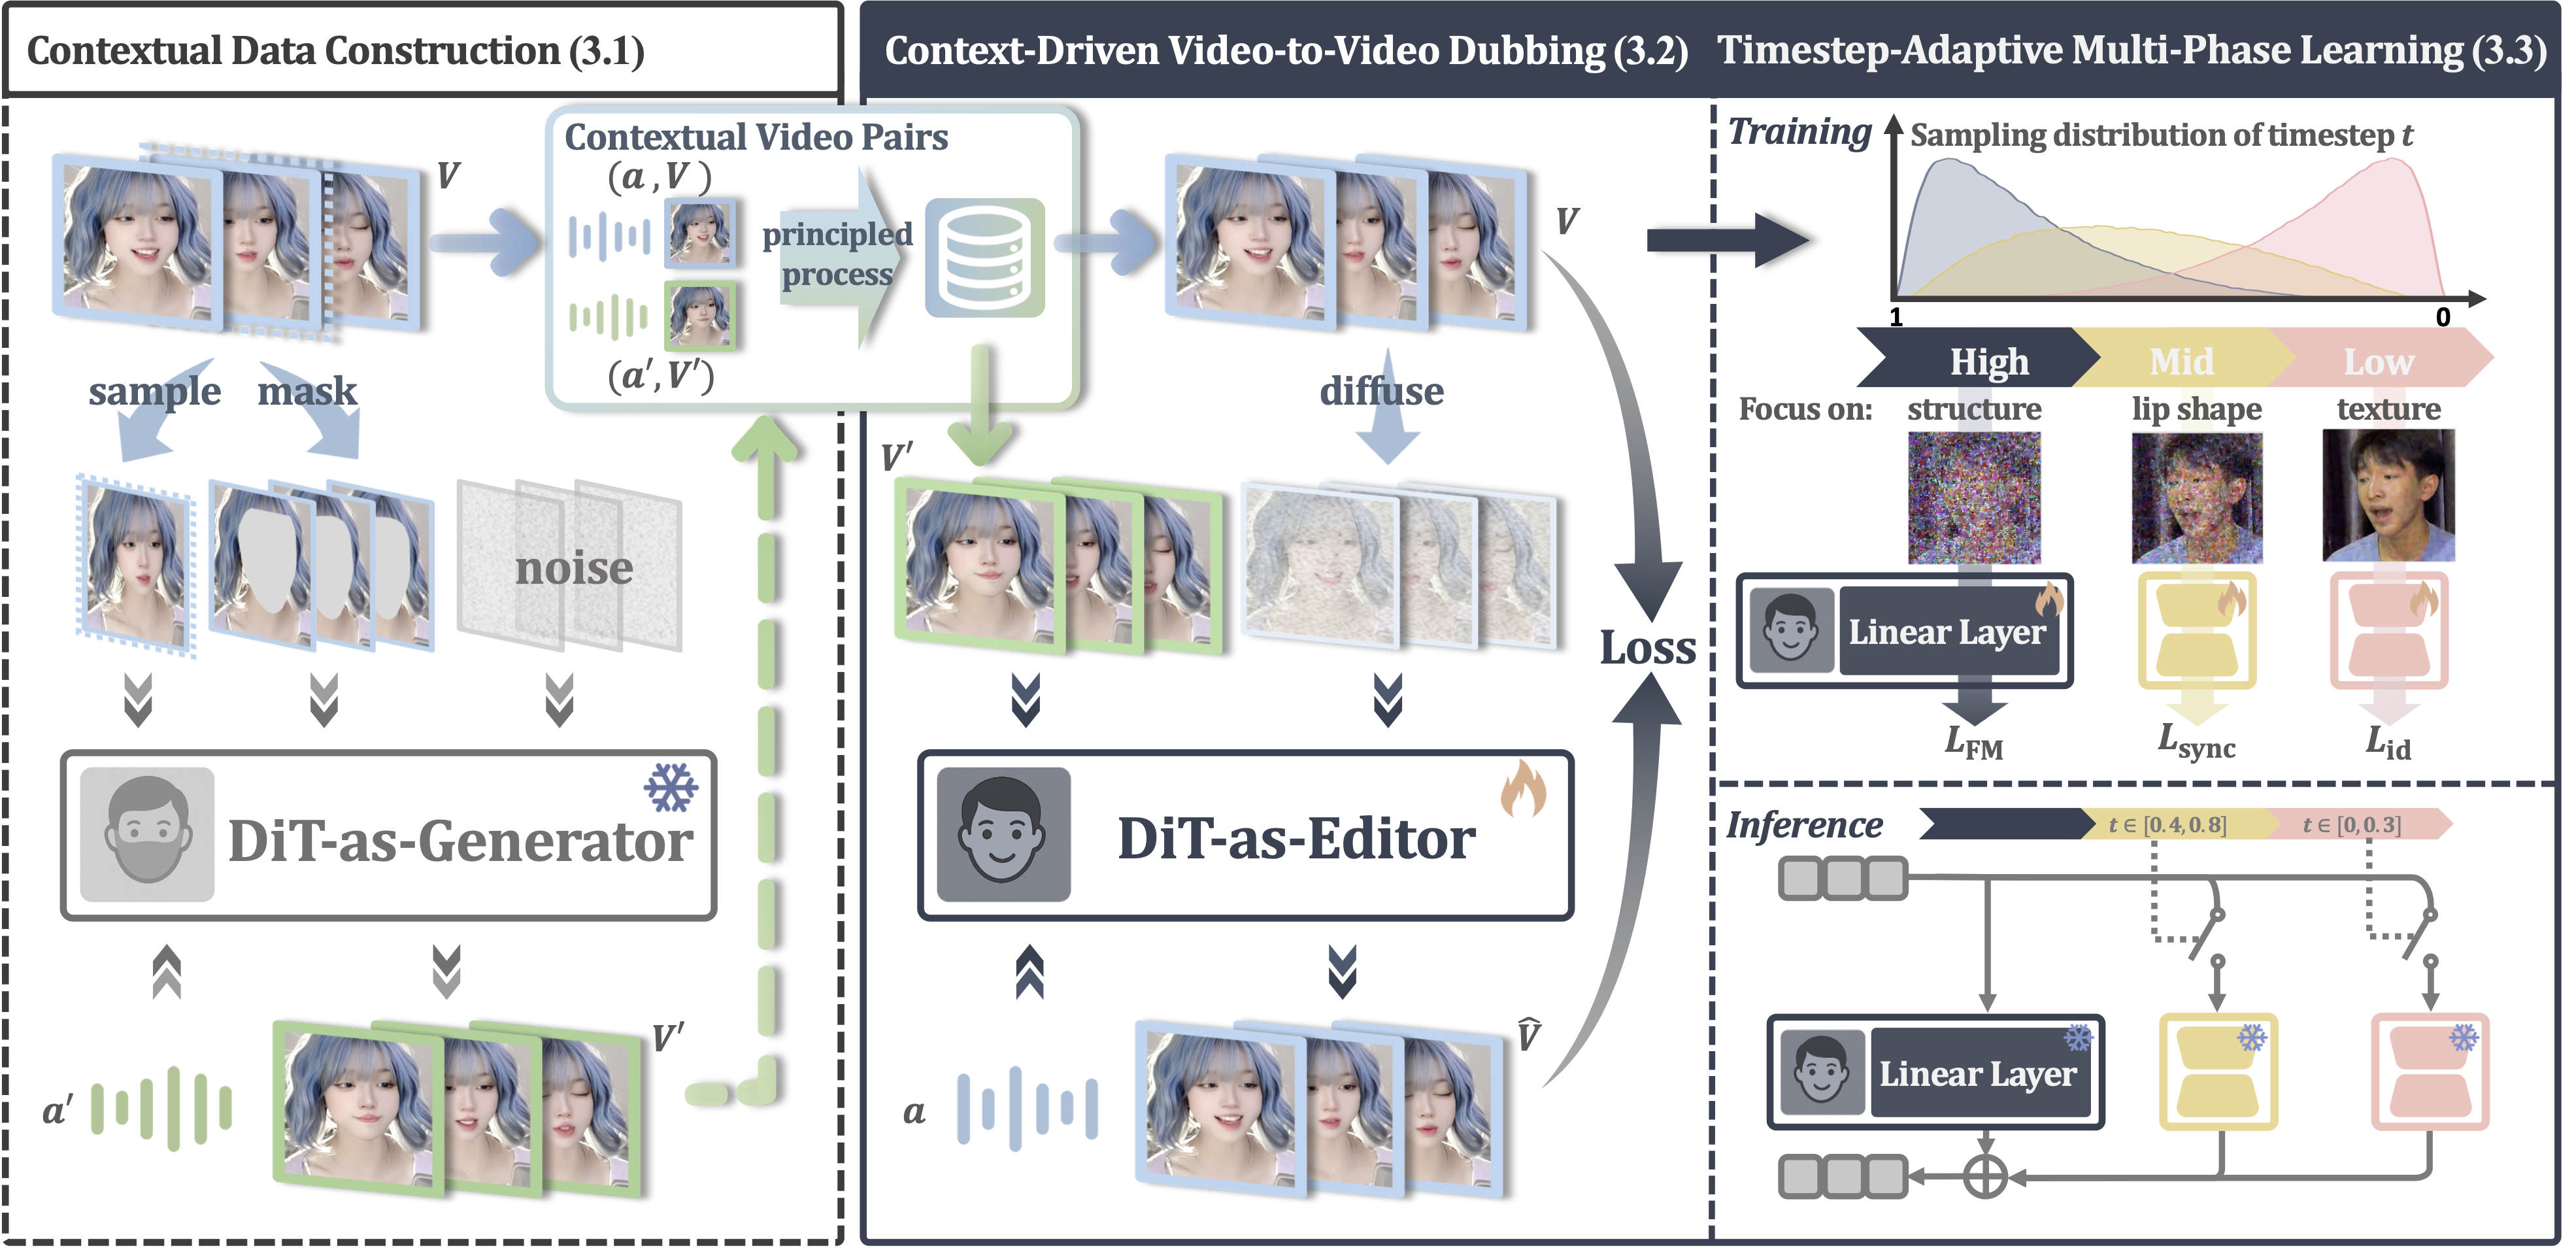
我们针对语音驱动视觉配音中的身份漂移、唇形泄漏以及基于掩码的图像修复方法不稳定等问题, 提出了 X-Dub,将图像修复模型复用为伪配对数据生成器,以自举方式训练免掩码的编辑式配音模型, 并引入时间步自适应的多阶段训练策略和新的 X-DubBench 评测基准。

Teaser
ICML'26

S. Li, S. Zhuang, W. Song, X. Zhang, H. Chen, A. Hao

我们研究如何根据连续文本合成语义连贯、过渡自然的人体运动。方法采用 L2G 语义融合与过渡推理模块,并设计了专门的过渡损失函数,同时构建了新的 STDM 数据集。

Teaser
ICCV'23

教育经历

计算机应用技术 博士

2022 - 至今
北京航空航天大学,中国

我目前是北京航空航天大学虚拟现实技术与系统全国重点实验室的博士研究生,导师为李帅教授。我早期的研究兴趣是微表情识别(2022年,西电本科毕业设计),目前的研究方向是语音驱动的三维说话人头。

计算机科学与技术 学士

2018 - 2022
西安电子科技大学,中国

我于2022年在西安电子科技大学计算机科学与技术学院获得学士学位。2020至2022 年期间,我在智能辅助教学中心(CIAT实验室)担任本科生研究助理,研究兴趣包括学生学习投入度预测(2020)与头部姿态估计(2021)。